


天基综合信息系统全国重点实验室入选NeurIPS 2026论文概览
近日,软件所天基综合信息系统全国重点实验室多篇论文被机器学习领域国际学术会议Conference on Neural Information Processing Systems 2026 (NeurIPS 2026)录用。以下是成果介绍,欢迎大家交流讨论。
1. Dirichlet-Guided Group Forecasting for Alleviating Over-smoothing in Time Series Forecasting
作者:张星宇,王婧瑶,喻心,宋泽恩,张健琦,郑昌文,强文文
时间序列预测广泛应用于电力调度、气象分析、交通管理和能源系统等领域。现有预测模型虽然能够较好拟合未来序列的整体趋势,但往往会削弱尖峰、振荡、转折点和状态切换等关键动态结构,产生过于平滑的预测结果。在部分观测条件下,同一历史序列可能对应上升、下降、振荡或突变等多种合理未来,而训练数据通常只提供其中一次实际发生的轨迹。在这种单次实现监督下,不同潜在未来模式容易被压缩或平均为一条中心化预测轨迹。即使简单增加多个预测头,也无法保证不同未来模式得到保留,仍可能收敛到相同的条件均值。
为此,研究团队提出Dirichlet引导的组预测框架DGF(Dirichlet-Guided Group Forecasting)。该框架根据历史序列学习多个模式条件预测分布,使不同预测分支分别描述潜在的未来动态模式;同时利用Dirichlet分布建模不同模式选择概率的不确定性,使模型既能判断不同模式出现的相对可能性,也能够描述这一判断本身的置信程度。在此基础上,DGF采用组级层次采样机制生成多组候选未来,并通过分层GRPO从预测精度、动态一致性和模式多样性三个方面进行联合优化,在保证预测质量的同时降低不同模式发生坍缩的风险。
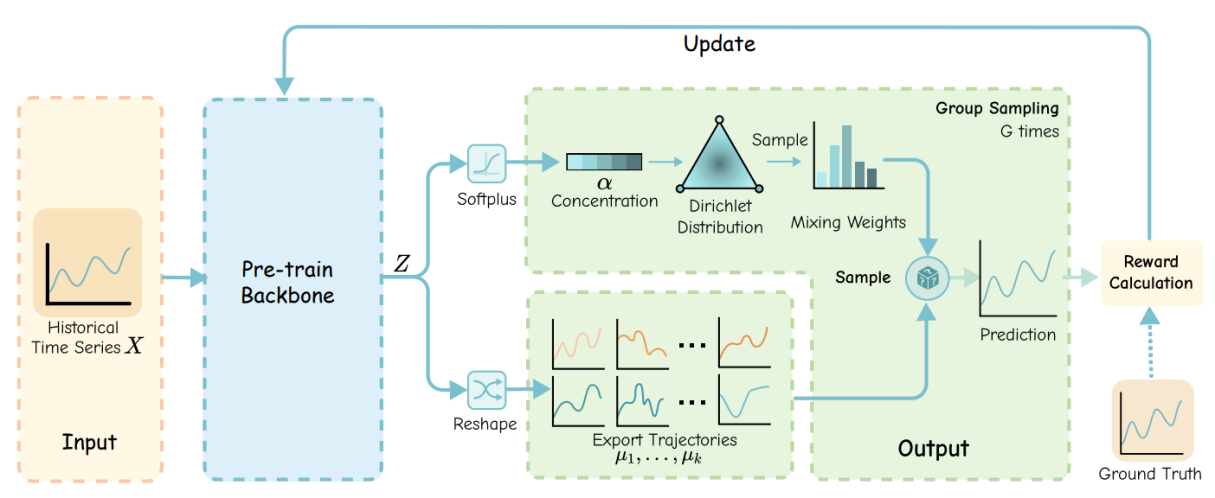
DGF框架图
研究团队在多个真实世界时间序列数据集上进行了系统评估。在长序列预测任务中,DGF基于Moirai-small和Moirai-base均能够稳定改善预测性能,并在多数数据集上取得领先结果;在概率预测任务中,DGF在CRPS和MSIS等指标上同样表现较优。此外,针对过平滑问题的专项实验表明,DGF能够同时改善预测误差和动态结构相关指标,验证了模式保留预测机制的有效性。
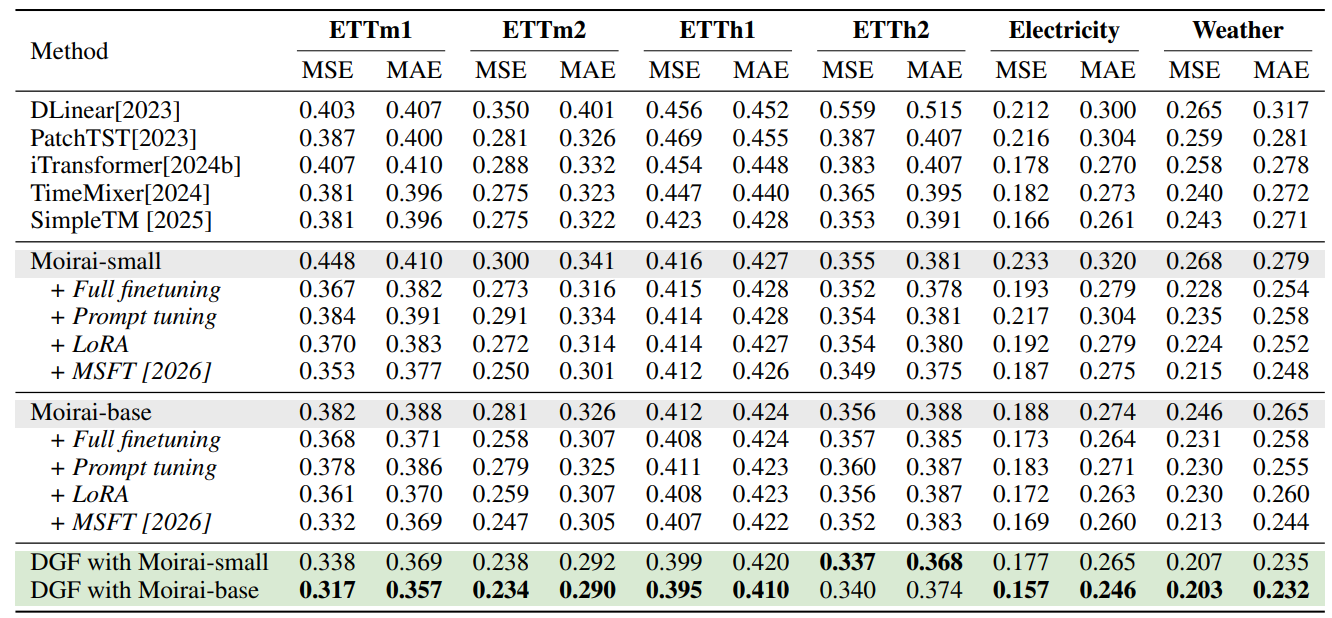
对比实验结果
论文链接:https://arxiv.org/abs/2606.10592
2. PAPO-VLA: Planning-Aware Policy Optimization for Vision-Language-Action Models
作者:郭沛正,王婧瑶,郑昌文,强文文
视觉语言动作(Vision-Language-Action,VLA)模型能够根据视觉观察和语言指令生成机器人动作。但一项机器人操作任务通常包含接近、抓取、移动和放置等多个连续阶段,不同动作对最终任务成功的影响并不相同。而现有VLA训练方法主要依赖动作模仿或轨迹级奖励进行策略优化,缺乏不同动作对任务结果影响程度的显式区分。
针对这一问题,研究团队从规划器(Planner)与执行器(Executor)的功能视角分析VLA策略,提出了面向视觉语言动作模型的规划感知策略优化方法PAPO-VLA(Planning-Aware Policy Optimization for Vision-Language-Action Models)。该方法首先结合动作变化程度和轨迹执行结果识别候选规划动作;再通过因果充分性与因果必要性比较,保留或扰动规划动作后的轨迹回报,估计其对任务成功的影响程度;最后将规划动作的重要性融入组相对策略优化(GRPO)的优势估计,使策略优化在考虑整体轨迹回报的同时,更有针对性地优化关键规划动作。
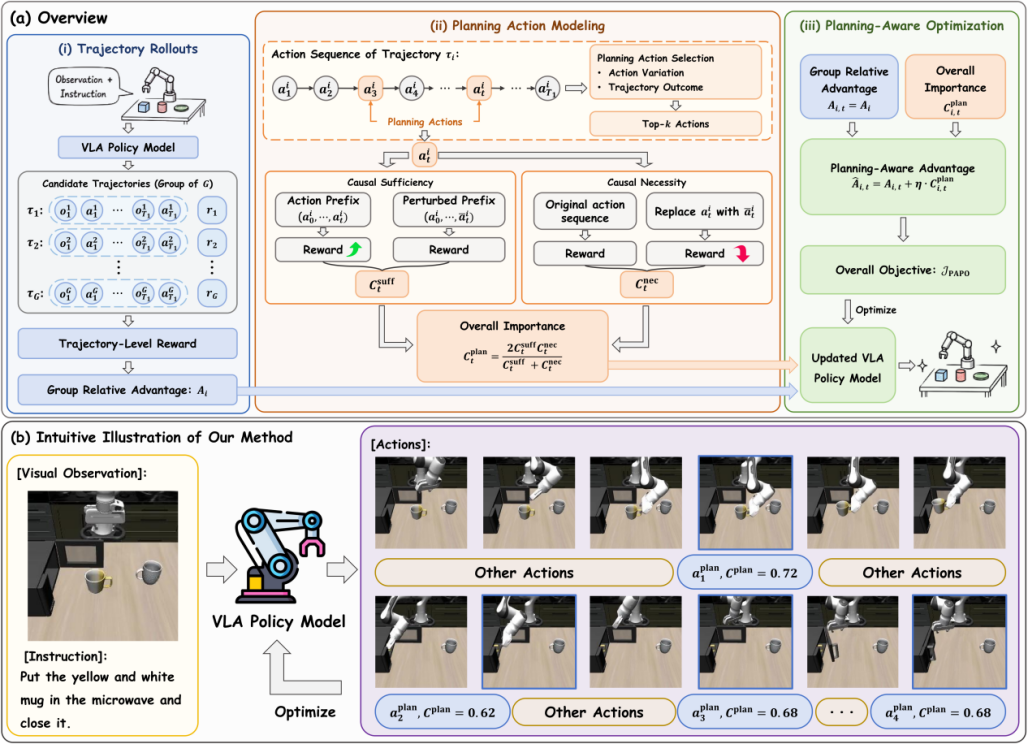
PAPO-VLA框架图
研究团队在LIBERO和RoboTwin2.0两个机器人操作仿真基准上开展实验,涵盖不同类型和执行长度的操作任务。在LIBERO上,PAPO-VLA的平均任务成功率达到96%,相比OpenVLA-OFT提升了5%;在RoboTwin2.0上,PAPO-VLA在短时序、中等时序以及长时序和超长时序任务组的平均成功率分别达到58.6%、69.5%和63.8%,在不同执行长度的任务中均取得了成功率提升。
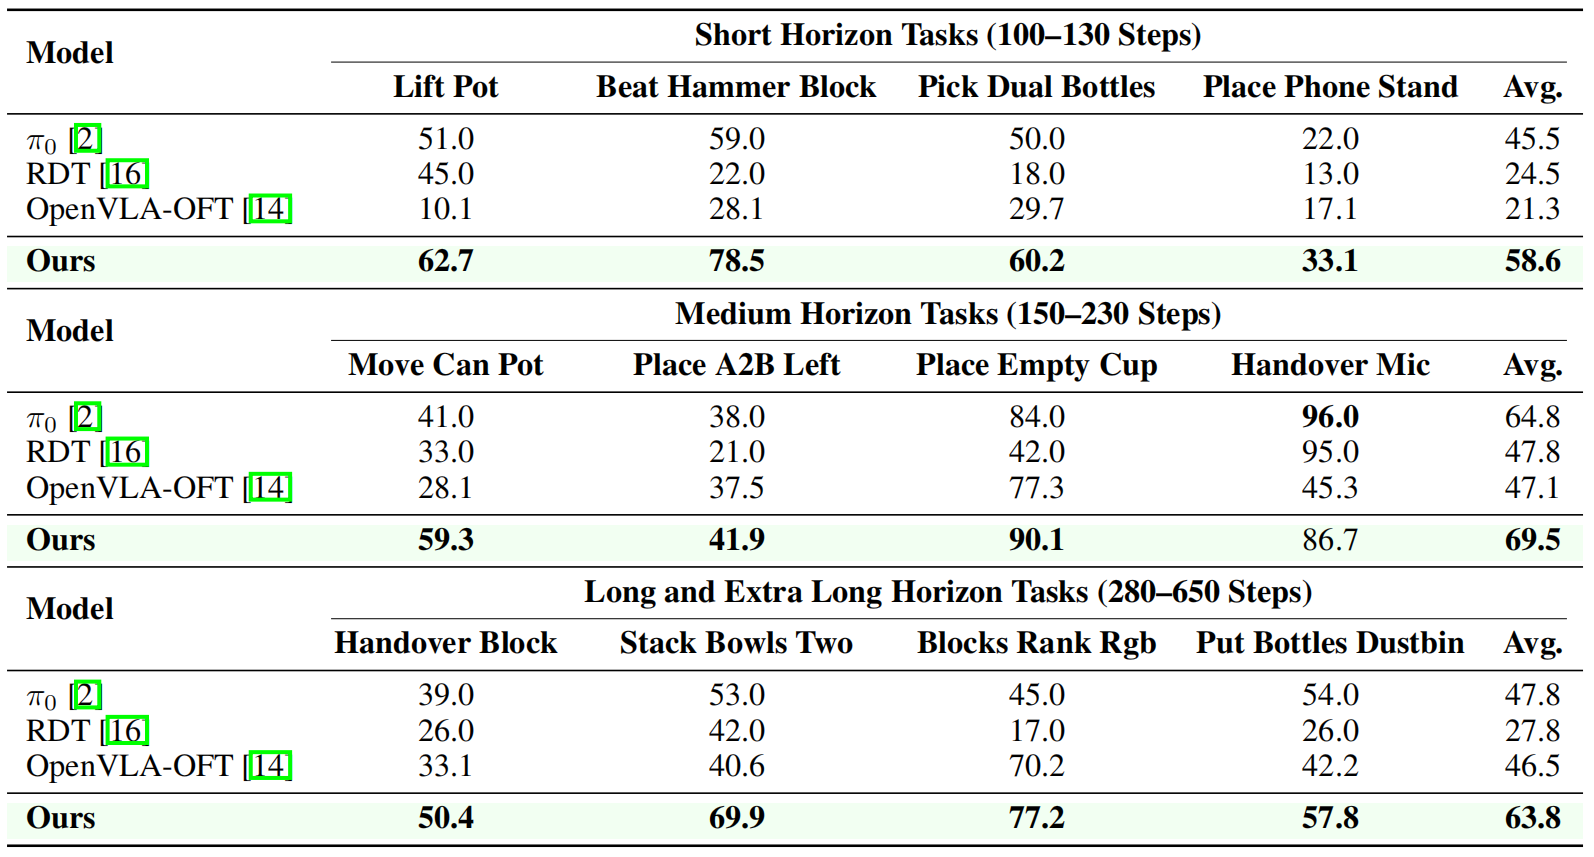
对比实验结果
论文链接:https://arxiv.org/abs/2605.19580
3. OGPO: Offline Goal-conditioned Policy Optimization for Recoverable Vision-Language-Action Models
作者:高旭乐,王惜,臧泽华,王瑞,郑昌文,孙楚雄
视觉语言动作(VLA)模型通过联合建模视觉感知、语言指令与机器人动作,为实现通用机器人操作提供了重要技术路径。现有VLA模型主要依赖专家演示数据进行监督微调,通过模仿专家动作学习任务执行策略。然而,这种训练方式高度依赖演示轨迹的覆盖范围,当机器人在实际执行中因环境变化、动作误差等而偏离预定轨迹时,模型往往难以自主恢复,容易在长时序任务中产生累积误差。在线强化学习虽然能够通过环境交互改善策略的恢复能力,但需要大量机器人交互与试错,训练成本较高。因此,如何充分利用已有离线数据,在不增加在线交互成本的情况下提升VLA模型的任务恢复能力,成为一个重要研究问题。
针对上述问题,研究团队提出离线目标条件策略优化框架OGPO(Offline Goal-conditioned Policy Optimization),将传统基于专家轨迹的动作模仿转化为面向任务关键状态的目标条件策略优化。该框架首先根据机器人夹爪状态变化对离线轨迹进行分段,并结合视觉语言模型识别失败轨迹中已经完成的局部目标,从而充分挖掘成功与失败轨迹中的任务进展信息;进而根据目标完成情况构建包含进度奖励与终端反馈的目标条件奖励,并利用价值函数估计不同状态到达目标的潜在收益;最后通过优势加权策略优化强化高价值动作,引入监督微调约束,避免策略偏离合理的专家动作分布。该框架无需额外在线环境交互,即可实现对VLA策略的离线优化。
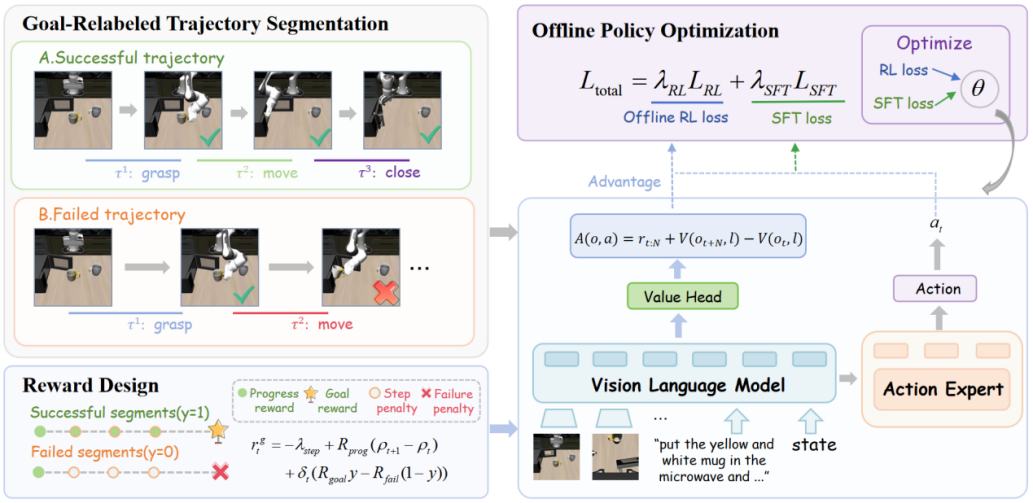
OGPO框架图
研究团队在LIBERO、MetaWorld-MT50等机器人操作基准上开展实验,并进一步利用LIBERO-Plus和自建的LIBERO-ReAct扰动基准评估模型的鲁棒性与恢复能力。在LIBERO上,OGPO将π0.5少样本微调策略的平均成功率从77.1%提升至97.1%,超过完整监督微调模型(96.85%),接近在线PPO强化学习方法(98.0%)。在MetaWorld-MT50 上,OGPO将π0模型的平均成功率从50.8%提升至81.0%,将π0.5模型从43.8%提升至67.2%。此外,在未经针对性扰动微调的情况下,OGPO将LIBERO-Plus与LIBERO-ReAct的总体鲁棒性得分从76.7%提升至81.8%。
