


QiMeng-GEMM:利用大语言模型在自动生成高性能GEMM代码
1. 成果简介
随着RISC-V、深度学习加速器的快速发展,针对复杂多样且不断演进的指令集和硬件架构,高效自动生成高性能库发挥硬件算力优势,对于软硬件生态发展具有重要作用。大语言模型(LLM)可以为简单任务生成功能正确的代码,但还不能深入理解不同硬件架构,难以生成高性能的矩阵乘法代码。
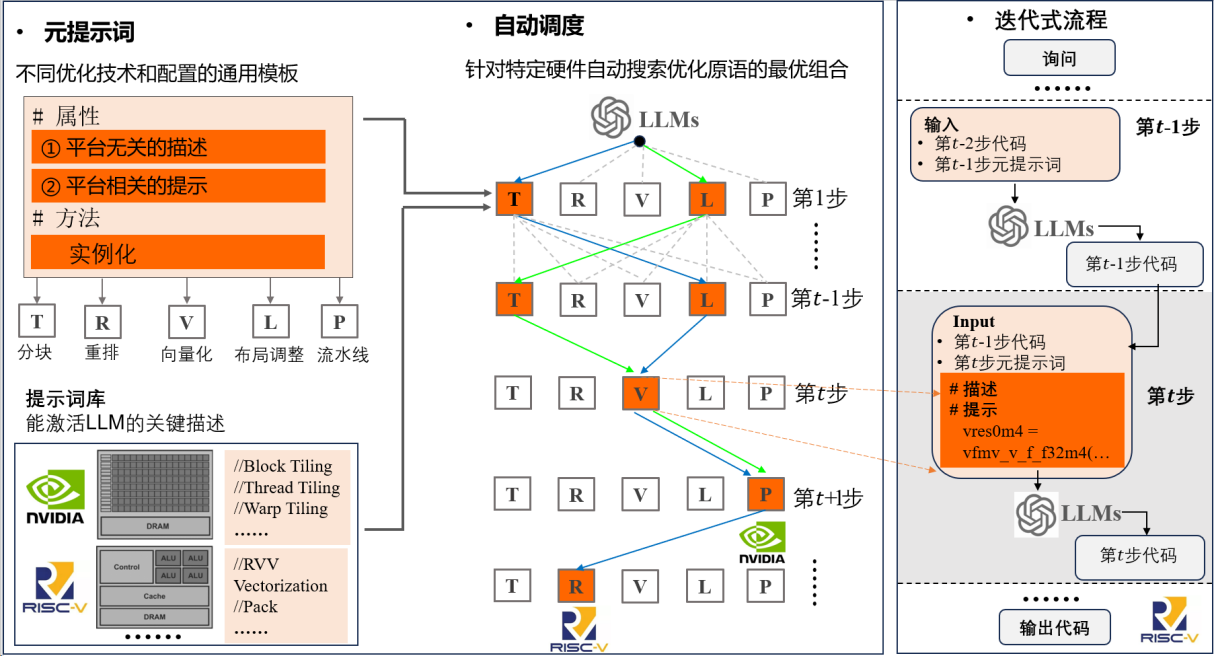
QiMeng-GEMM提出了首个基于大模型的高性能矩阵乘法代码自动生成框架,通过一组信息丰富、自适应、可迭代的元提示,引导LLM理解不同硬件平台的架构特征,并在提示词基元的基础上,自动搜索最优的优化策略组合,以生成高性能GEMM代码。实验结果表明,在4种主流LLM以及多个代表性硬件平台以及典型矩阵规模的测试中,QiMeng-GEMM显著超越了传统提示方法,在自动优化GEMM代码方面最高提升达113倍。相比人工优化,该方法在NVIDIA GPU上可达cuBLAS的115%,在RISC-V CPU上达到OpenBLAS的211%,且将优化周期从数月缩短至数分钟,大幅提升了开发效率。相关工作发表在AAAI2025(CCF A会议)。
2. 技术创新点
该成果技术创新主要体现在以下方面。
(1)信息丰富的功能级元提示设计:QiMeng-GEMM 提出了一组涵盖五种常见 GEMM 优化技术(块划分、重排、向量化、数据布局、流水线)的元提示,并结合平台特定提示,使 LLM 能够充分理解不同硬件架构的优化需求。
自动化元提示搜索机制:提出一种自动搜索优化原语组合,探索比人工调优更优的优化策略。
(2)多硬件平台适配性:QiMeng-GEMM可以跨不同架构、硬件特性平台,生成高性能算子。
3. 技术成熟度
该成果当前处于中试阶段(工程化验证)。
4. 可应用领域
QiMeng-GEMM的代码自动生成能力在基础科学计算库开发、高性能深度学习算子开发等领域具有非常广阔的应用前景。通过定义一组优化原语,能够自动在不同计算单元上生成高性能GEMM算子,大大减少了编程难度和开发效率,特别是降低了在层出不穷的新兴硬件架构(如RISC-V)上的开发代价,并能够取得较高的算子性能。
5. 联系人
周其睿,zhouqirui22s@ict.ac.cn,15623614160

