


多模态笔式界面和草图交互关键技术及平台
1. 成果简介
笔式交互是一种自然且重要的用户界面输入方式,可以支持用户便捷地在智能设备上完成手绘草图和手写文字等内容的生产,从而实现用户思维与意图的高效传达。相比于触控、键鼠、语音等其它交互方式,草图输入内容相对抽象,语义表达通常较为模糊,且依赖于对时空上下文的完整理解,对准确理解用户交互意图形成了巨大挑战。在新一代用户界面形态中,多模态智能笔式界面将融合草图笔画、语音、文字、图像、视频等模态一同组成多模态交互界面的关键要素,共同构建对用户交互意图的充分建模和理解,实现更加自然的界面交互方式。
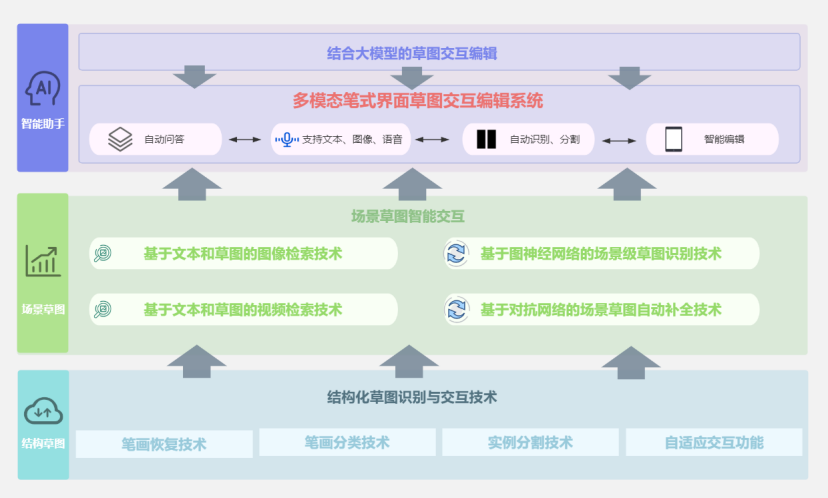
当前的技术难点主要在于实现对手绘草图的精准识别与深入理解、草图场景的智能补全以及融合多模态的草图检索的高效匹配。多模态笔式界面草图交互关键技术及平台旨在提供集成化、多场景、多任务的草图编辑和检索功能,提升用户交互体验和交互效率。平台主要具备以下特色:
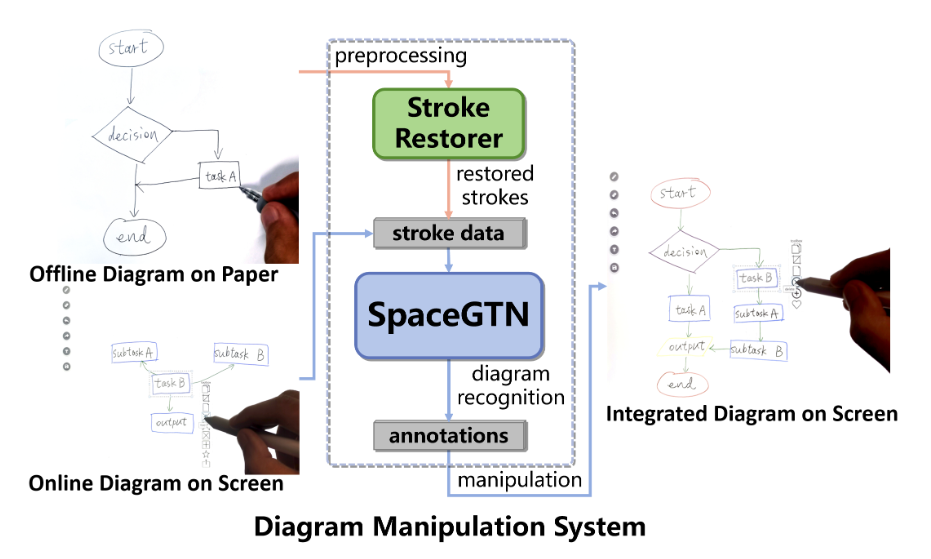
(1)基于动态图神经网络的手写内容识别理解与智能交互技术,通过草图元素的精准分割与智能分类,提升草图识别的准确性。该技术能根据输入的草图自动分割图像区域,识别出不同的草图结构、类别,支持对离线图像形式的草图和在线笔画形式的草图进行识别,并实现结构化草图与场景草图的笔画级编辑,可以根据草图类别自适应地提供结构修改、选择、收起展开等辅助功能,从而为后续的检索和编辑操作提供支持。
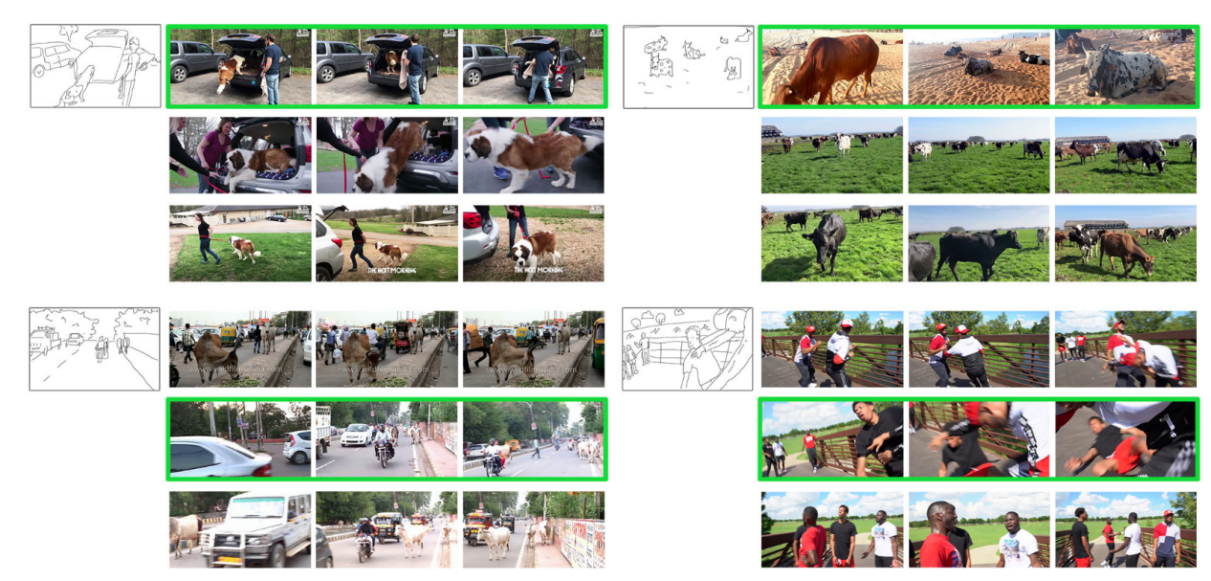
(2)基于扩散模型的草图文本融合的图像/视频检索技术,通过全局-局部注意力机制和扩散模型,将草图与文本数据进行特征融合,并依据融合后的特征针对图像/视频进行细粒度检索。该技术支持场景级草图与图像/视频内容精准匹配,使得输入的场景草图和检索出的图像/视频不仅具有相同的场景类别,而且在场景空间布局、各实例对象的视觉特征、大小、位置等细节上均保持一致。
(3)基于对抗网络的场景草图自动补全技术,针对绘制过程中存在的大量非完整草图(因缺损或遮挡等原因造成),结合了草图补全与草图识别任务,使用级联模型,构建多任务模型,以草图补全为主任务,草图识别为辅助任务,自动预测并生成缺失部分,确保草图的连贯性,显著提升草图编辑效率。
(4)基于大模型的多模态智能草图交互系统,该系统支持多种输入方式,包括文本、语音、草图、图像、视频等,实现多模态数据的综合处理和分析。平台集成了场景草图识别、细粒度检索、自动补全、个性化生成等多种功能,支持高效的笔式界面交互,并基于大模型实现语音和文本对草图的智能编辑,显著提升用户体验。
2. 技术创新点
提出一种融合草图、文本、语音、图像、视频等多模态信息的智能笔式交互框架,突破了多模态融合感知与意图理解的技术瓶颈,克服了多模态数据融合过程中丢失特征以及离线和在线草图识别方法不统一的问题;实现了多模态交互数据的精准理解与分析,通过多模态编码器对笔式轨迹、语音信号、图像及文本等输入进行特征提取和高维表示,采用多头自注意力机制和跨模态注意力机制,研究模态之间的信息传递与语义对齐,实现精准的交互意图识别;开发面向多模态输入的上下文感知与动态交互调整策略,实现上下文融合模块,支持多模态数据的高效融合,提供个性化、精准的图像与视频检索服务;实现基于大模型的多模态智能编辑系统,综合处理多模态数据,提供智能化、个性化的编辑体验,显著提升了用户的交互效率与操作体验。
3. 技术成熟度
该成果当前处于中试阶段(工程化验证)。其中平台中的手写内容理解与智能交互方法,部分成果已处于产品化阶段,在华为新版鸿蒙平板系统中搭载,实现落地应用。
4. 可应用领域
该成果可应用于工业设计与产品原型开发、创意设计与艺术创作、教育与培训、信息管理与检索等领域。
5. 联系人
马翠霞,cuixia@iscas.ac.cn,13651317791

