


语音交互与言语障碍康复训练技术
1. 成果简介
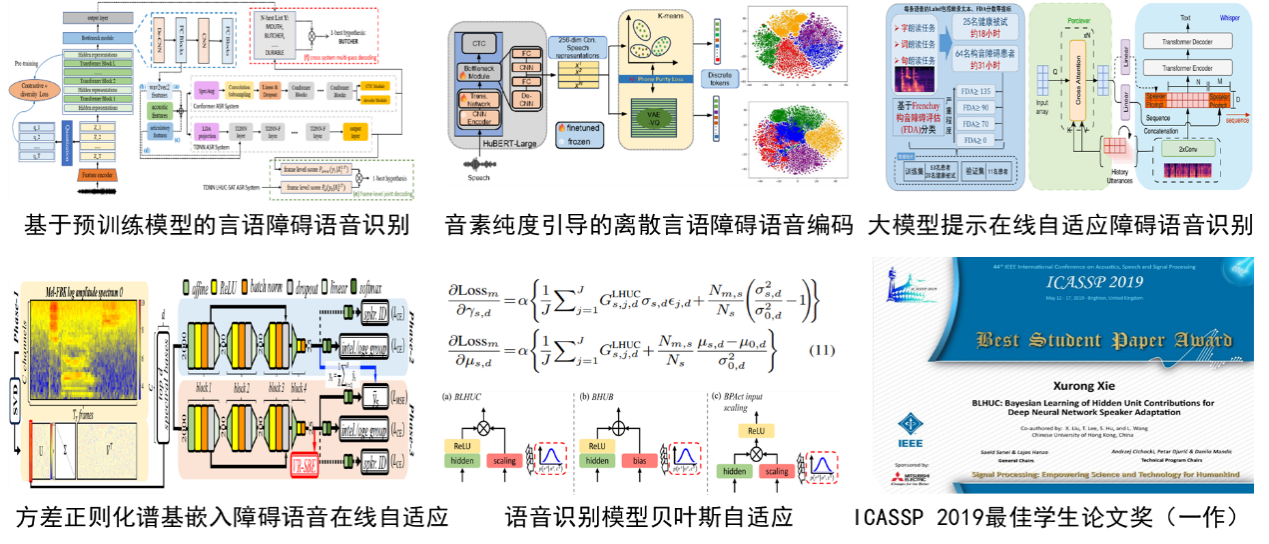
面向语音交互与言语障碍康复训练,提出了一系列语音识别建模技术,包括基于预训练模型编码的障碍语音识别与评估技术、基于端到端语音模型的鲁棒贝叶斯自适应技术和在线自适应技术,构建了多个具有国际先进性能的障碍语音识别系统,在UASpeech、TARGO、DementiaBank英语和CUDYS、JCCOCC MoCA中文数据上多次获国际最先进性能。提出了一系列对齐融合语音及口部视频、舌部超声等发音器官运动特征的多模态建模技术,增强语音信号中的目标音素信息,提升言语障碍语音识别性能,在超过80个参赛队伍中获得“国际会议ISCSLP 2024多模态构音障碍严重程度评估挑战赛”第三名。
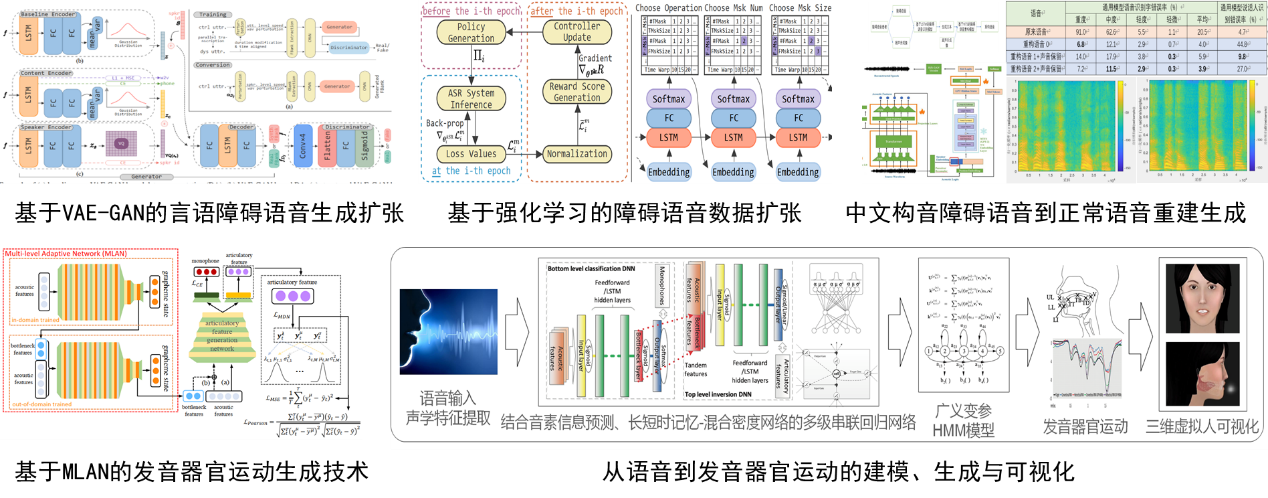
此外,开展了一系列言语障碍相关语音生成技术研究,提出多种基于语音识别-语音合成系统级联及端到端语音生成系统的构音障碍语音重建技术,将患者障碍语音转换为清晰语音,同时保留患者原本声音,辅助患者言语交流;重建后的中文语音在一般语音识别系统上错误率跟正常语音相当。
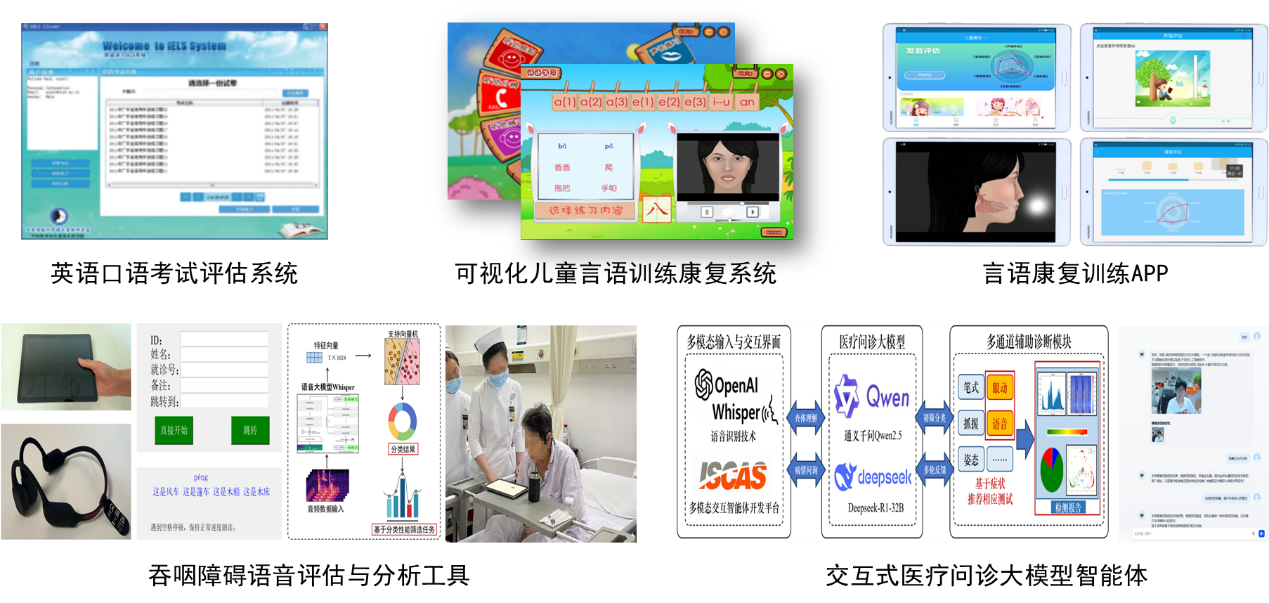
相关成果在语音领域国际顶会Interspeech、ICASSP,国际顶刊IEEE TASLP等共发表论文50余篇,申请相关专利10余项。研发的语音相关技术已应用于多种实际工具,如面向儿童及青少年英语口语学习的评估系统、儿童及成人言语障碍训练的康复软件、临床吞咽障碍语音评估与分析工具、语音及语言交互式问诊大模型智能体等。
2. 技术创新点
该技术先进性主要体现在以下四个方面:
(1)面向障碍语音识别任务,结合预训练语音模型低参微调方法引入了一种可训练模块,从语音中生成鲁棒连续特征向量或域不变离散特征标记并与原始语音拼接,使语音识别模型适应障碍语音与正常语音的差异,在障碍语音识别性能上取得了显著提升。
(2)面向语音建模时说话人声音、健康状况、环境噪声等复杂条件导致的特异性与差异性问题,提出了结合贝叶斯学习与置信度估计模块的端到端模型自适应方法,并结合基于注意力的估计模块及条件预测模块实现在线快速自适应,显著提升一般场景多人对话、复杂场景噪声语音、不同程度言语障碍语音的识别性能。
(3)面向阿尔茨海默病检测,采用深度神经网络架构,结合速度扰动等数据增强技术,利用贝叶斯方法和说话人自适应方法与语言模型融合提取相关特征,在疾病检测任务中取得了较高的准确度。
(4)基于语音与视觉多模态交互任务,利用自监督学习的预训练模型对构音障碍患者的语音和唇部运动视频进行同步采集与分析,采用特征级融合与后端融合两种方式,将音频与视觉特征映射至统一参数空间,提升了构音障碍严重程度的分类与分级准确率。
(5)提出了一种构音障碍语音重建系统,通过对障碍信息鲁棒的语音编码技术,利用对抗生成模型及扩散模型恢复构音障碍语音中的音素嵌入,并通过上下文学习机制提取说话人的语音特征,从而在保留说话人身份特征的基础上生成清晰的重建语音。
3. 技术成熟度
该成果当前处于应用验证阶段,系列技术已形成多项技术、系统和工具,已应用部署在多家医院。
4. 可应用领域
该成果已产出一系列软件、技术、系统和工具,可应用于医院言语或认知障碍临床检测、居家自测与康复干预等多个关键环节。
5. 联系人
谢旭荣,xurong@iscas.ac.cn,18576787032
